Hydrus Network помогает собирать, систематизировать и разбирать большие личные коллекции изображений, видео, аудио и других медиафайлов, когда обычных папок уже недостаточно: программа строит работу вокруг тегов, поиска по метаданным, очередей импорта, загрузчиков, подписок и фильтра похожих файлов. Она особенно полезна тем, кто хранит десятки тысяч файлов из разных источников, хочет быстро находить материалы по нескольким признакам одновременно, отделять новые поступления от уже разобранных и не терять связанные теги при экспорте или очистке коллекции.
- Ретушь портретов и коррекция кожи
- Замена фона и удаление объектов
- 200+ фильтров и фотоэффектов
- Импорт в собственное хранилище
- Сложная настройка продвинутых функций
- Нет полноценного редактора изображений
Как устроена работа с коллекцией
Главное отличие Hydrus Network от обычного просмотрщика фотографий — файл после импорта становится объектом внутренней базы. Клиент копирует его в собственное файловое хранилище, вычисляет хэш и связывает с ним теги, URL источников, рейтинги, заметки, состояние inbox/archive и сведения о связях с дублями. Исходный файл, из которого выполнялся импорт, после успешного добавления коллекции для дальнейшей работы не нужен: Hydrus обращается к своей копии. Это важно понять до массового импорта, потому что структура каталогов пользователя не является основной навигационной моделью программы.
Файлы идентифицируются прежде всего по хэшу. Поэтому точная копия с другим именем не превращается в новый независимый объект коллекции: Hydrus распознаёт уже известное содержимое. Имена папок и файлов можно использовать во время импорта как источник тегов, но они не становятся постоянной «осью» библиотеки. Взамен пользователь получает возможность описывать один материал сразу несколькими независимыми признаками: автором, серией, персонажем, типом сцены, источником, статусом обработки и любыми собственными категориями.
На практике это меняет способ обслуживания архива. Вместо дерева вроде Картинки/Художники/Автор_A/Серия_B можно назначить одному файлу теги creator:author_a, series:series_b и, например, status:reference. Затем тот же файл появляется в результатах каждого соответствующего поиска без копирования между папками. Для коллекций, где один материал логически относится к нескольким категориям, такая схема снимает неизбежную проблему «в какую единственную папку его положить».
Внутренняя модель накладывает и дисциплину: не следует открывать каталог client_files и вручную переименовывать, заменять или удалять файлы. Для редактирования изображения безопасный путь другой: экспортировать его, изменить во внешнем редакторе, затем импортировать получившийся файл как новую версию и при необходимости связать версии через систему дубликатов или альтернатив. Если требуется обычная файловая библиотека, где программы совместно редактируют одни и те же оригиналы на месте, архитектура Hydrus может оказаться неудобной.
Установка и начало работы
Для Windows проект распространяет готовую сборку и вариант установки с распаковкой, для Linux — готовую сборку, ориентированную на Ubuntu, а также запуск из исходного кода. На macOS основной поддерживаемый путь в официальной документации связан с запуском из исходников. При выборе варианта важнее не форма установки, а место базы: вместе с коллекцией она со временем становится ценнее самого исполняемого файла.
По умолчанию рабочие данные находятся рядом с программой в каталоге db, а медиа — во внутренних подкаталогах файлового хранилища. Такой подход делает перенос установки достаточно прямолинейным, но не означает, что базу можно бездумно разместить где угодно. Разработчик отдельно не рекомендует держать активную SQLite-базу на сетевом ресурсе: файловые блокировки и задержки сети плохо сочетаются с ожиданиями локальной базы. Также нежелательно включать файловое сжатие для каталога живой базы, если оно добавляет заметную задержку операций.
Перед первым крупным импортом имеет смысл определить три вещи: на каком диске будет жить база, где хранить её резервную копию и каков допустимый объём внутреннего хранилища. Hydrus не является каталогизатором, который просто индексирует существующие папки и оставляет файлы на местах; массовый импорт создаёт собственные копии. Если на исходном диске 500 ГБ материалов, для нормальной миграции требуется заранее понимать, куда попадёт сопоставимый объём данных и где будет лежать резервная копия базы.
Первый запуск не требует подключения к чужим серверам. Обычная локальная библиотека работает самостоятельно. Сетевые функции — загрузчики сайтов, подписки, Public Tag Repository, Client API и серверные возможности — подключаются по необходимости. Поэтому разумный старт — импортировать небольшую тестовую папку, освоить теги и поиск, а уже затем переносить основной архив.
Обновление без риска для базы
Hydrus не обновляет себя автоматически. Перед обновлением документация рекомендует сделать резервную копию. При использовании установщика или распаковываемой сборки обновляется программная часть, а база проходит миграцию при следующем запуске. Большие пропуски между версиями лучше не перепрыгивать вслепую: клиент умеет отказываться от слишком далёкого перехода и в таком случае потребуется промежуточная версия. Смысл ограничения — провести последовательные изменения схемы данных в ожидаемом порядке.

Практический порядок простой: закрыть клиент, убедиться, что резервная копия закончена, обновить программу, запустить и дождаться завершения миграции. Не стоит прерывать первое открытие после обновления только потому, что оно длится дольше обычного: преобразование таблиц, пересчёт индексов или фоновые задачи на большой базе объективно требуют времени. Если версия запускается из исходного кода, обновление затрагивает также зависимости окружения; здесь особенно важно сверяться с документацией конкретной ветки.
Главное окно, страницы и просмотр файлов
Рабочее пространство Hydrus строится из страниц. На одной странице может быть результат поиска, на другой — галерейный загрузчик, на третьей — очередь URL, watcher или обработка дубликатов. Это позволяет держать несколько независимых задач в одной сессии и не смешивать выборки. Новую страницу можно создавать через меню страниц; клавиша F9 открывает выбор новой страницы.
Сетка миниатюр — не просто файловый список. Результат поиска можно сортировать, собирать в коллекции, фильтровать и передавать в специальные режимы. Один щелчок выбирает файл и показывает сведения о нём, двойной или средний щелчок открывает media viewer. В просмотрщике колесо мыши или клавиши Page Up/Page Down переходят по файлам текущего набора, а сочетание с Ctrl управляет масштабом. Клавиша F переключает режим отображения кадра/полного экрана согласно назначенным действиям.
Полезно воспринимать страницу как временное представление базы, а не как папку. Закрытие поисковой страницы не удаляет файлы и не меняет их теги. Можно создать отдельную страницу для system:inbox, другую для конкретного автора, третью — для видео, а затем закрыть любую из них после обработки. Это снижает риск случайно превращать организацию интерфейса в организацию данных.
На очень больших выборках не стоит выводить всю библиотеку одной сеткой. Разработчик указывает, что интерфейс начинает заметно «скрипеть», когда на одной GUI-странице одновременно отслеживаются десятки тысяч объектов; в документации фигурирует ориентир порядка 40–50 тысяч файлов для одной рабочей страницы, а значительно большие сессии могут стать тяжёлыми. Это не бенчмарк и не жёсткий лимит, а практическое ограничение архитектуры интерфейса. Для повседневной работы лучше формировать узкие запросы и использовать system:limit.
Импорт файлов с диска
Обычный ручной импорт запускается через file -> import files. Файлы и папки также можно перетащить в окно клиента. В диалоге доступны добавление файлов и папок, удаление лишних позиций из списка, параметры импорта и опция удаления исходных файлов после успешного добавления. Последняя по умолчанию не должна превращаться в средство «освободить диск на удачу»: сначала стоит убедиться, что импорт прошёл, резервное копирование базы настроено и внутренняя копия открывается.
Перед запуском импорта можно выбрать add tags before import и назначить теги всей партии. Это удобнее, чем потом выделять тысячи миниатюр и восстанавливать общий контекст. Для локальных архивов полезны как минимум теги источника и логической партии, например source:old_archive и batch:2024_scans. Если структура исходных папок содержательна, Hydrus умеет извлекать части пути и имени в теги; этот сценарий стоит сначала проверить на десятке файлов, чтобы не засорить базу техническими названиями каталогов.
Точные дубликаты не добавляются как новые самостоятельные файлы. Если другой файл имеет тот же хэш, клиент распознаёт его как уже известный. Визуально похожие, но бинарно отличающиеся версии — например, JPEG после повторного сохранения, кадр другого размера или PNG того же изображения — являются отдельными файлами и позднее могут попасть в систему поиска похожих материалов.
Если Hydrus сообщает previously deleted, это не ошибка чтения файла. Клиент помнит хэш ранее удалённого объекта и по умолчанию защищает пользователя от циклического повторного импорта того, что он уже решил удалить. Для осознанного возврата таких файлов используются специальные File Filtering Import Options: можно создать пользовательский набор параметров и отключить исключение ранее удалённых файлов только для нужной операции.
Когда использовать удаление оригиналов после импорта
Флажок удаления исходника оправдан в контролируемом конвейере, например когда папка является временным «входящим» каталогом, а Hydrus — единственным конечным хранилищем. Для миграции семейного архива или рабочей коллекции безопаснее выполнить копирующий импорт, проверить выборку по количеству и нескольким случайным файлам, сделать резервную копию и только после этого самостоятельно решать судьбу исходников. Наличие внутренней копии не заменяет резервного копирования: повреждение единственного диска одинаково опасно для любой структуры хранения.

Не надо путать «файл уже есть в базе» и «все нужные метаданные уже получены». При локальном импорте основная задача — добавить медиа и назначенные вручную теги. При веб-загрузках один и тот же URL может дополнительно нести теги, заметки и другие сведения; для повторного получения метаданных предусмотрен отдельный механизм force metadata refetch, а не повторное скачивание бинарного файла.
Import Options: правила, определяющие судьбу импорта
Современная система Import Options разделена на семь типов. Они применяются к разным импортёрам и позволяют централизованно определять, что получать, что отбрасывать, куда помещать данные и что показывать в интерфейсе. Новому пользователю не требуется настраивать все семь разделов: стандартные параметры рассчитаны на обычную работу. Польза появляется тогда, когда возникает конкретное исключение — например, не принимать слишком крупные файлы, отсеивать материалы с определённым тегом или складывать теги ненадёжного сайта в отдельный сервис.
- Prefetch Import Options определяют, нужно ли повторно обращаться к уже известным URL и метаданным.
- File Filtering Import Options фильтруют по типу и свойствам файла, а также управляют исключением ранее удалённых объектов.
- Tag Filtering Import Options разрешают или запрещают импорт по полученным тегам.
- Location Import Options задают локальную область хранения и могут автоматически архивировать импорт.
- Tag Import Options решают, какие полученные теги в какой tag service попадут.
- Note Import Options управляют текстовыми заметками, которые парсер получает со страницы.
- Presentation Import Options определяют, какие результаты успешного импорта показывать пользователю.
Параметры складываются в систему уровней. Базовые глобальные значения действуют как запасной вариант; более конкретный контекст — тип импортёра, класс URL или конкретная задача — может их переопределить. Это позволяет настроить «в целом принимать всё как обычно, но на этом сайте брать только creator/series/character, а в этой подписке не показывать уже известные файлы». Важно помнить, что более конкретная настройка для данного типа опций именно заменяет менее конкретную, а не обязательно дополняет её. Слишком много исключений делает поведение трудно предсказуемым.
Для повторяющихся схем предусмотрены копирование, вставка и шаблоны/favourites. Это полезно, когда несколько URL Class должны получать одинаковый фильтр либо серия локальных импортов всегда направляется в один домен и автоматически архивируется. Правильный подход — сначала настроить один реальный сценарий и проверить результат, затем сохранить рабочую конфигурацию как шаблон. Настраивать десятки классов «на будущее» обычно только усложняет сопровождение.
Повторный импорт ранее удалённых файлов
Типичный случай: пользователь удалил часть импортированной партии, затем понял, что решение было ошибочным. Простое перетаскивание исходной папки снова даст статус previously deleted. Нужно открыть параметры конкретного импортёра, переключиться с defaults на custom import options и в File Filtering Import Options разрешить ранее удалённые файлы. Остальные типы параметров при этом можно оставить на значениях по умолчанию. После восстановления лучше вернуть обычную защиту, иначе в последующих массовых импортах могут незаметно вернуться файлы, которые действительно были отсеяны намеренно.
Фильтрация по тегам при скачивании
Tag Filtering Import Options работают после того, как парсер получил теги страницы, но до принятия файла в коллекцию. Можно создать blacklist для нежелательных категорий либо whitelist для редкого сценария «принимать только материал, содержащий такой тег». Это эффективнее, чем сначала скачать всё, а затем удалять тысячи файлов. Однако фильтр зависит от качества тегов источника: если сайт не выдаёт нужный тег или парсер его не распознаёт, правило не сможет принять решение на основе отсутствующей информации.
Отдельно Tag Import Options позволяют не доверять внешней разметке целиком. Например, теги загрузчика по умолчанию можно направлять в downloader tags, а для проблемного источника создать собственный tag service и пропускать туда только пространства имён creator:, series: и character:. Так сомнительная классификация не смешивается с вручную выверенными my tags.
Теги: базовый инструмент классификации
Для выделенных файлов диалог управления тегами открывается клавишей F3. В нём есть автодополнение и отдельные панели tag services. Ввод нового значения добавляет его выбранным файлам; существующее значение можно снять. Когда поле ввода пустое, применение/закрытие подтверждает сделанные изменения. При работе из media viewer изменения применяются по мере работы, поэтому диалог ведёт себя несколько иначе, чем массовое редактирование выбранной группы.
Hydrus поддерживает пространства имён через двоеточие. Запись creator:ivanov означает не путь и не специальный системный тип, а тег с namespace creator. Аналогично можно использовать series:, character:, location:, camera: или свои пространства имён. Польза namespace появляется в поиске, сортировке и визуальном представлении: можно искать всех авторов независимо от конкретного имени, сортировать по значению одного пространства и отличать одинаковые слова, используемые в разных ролях.
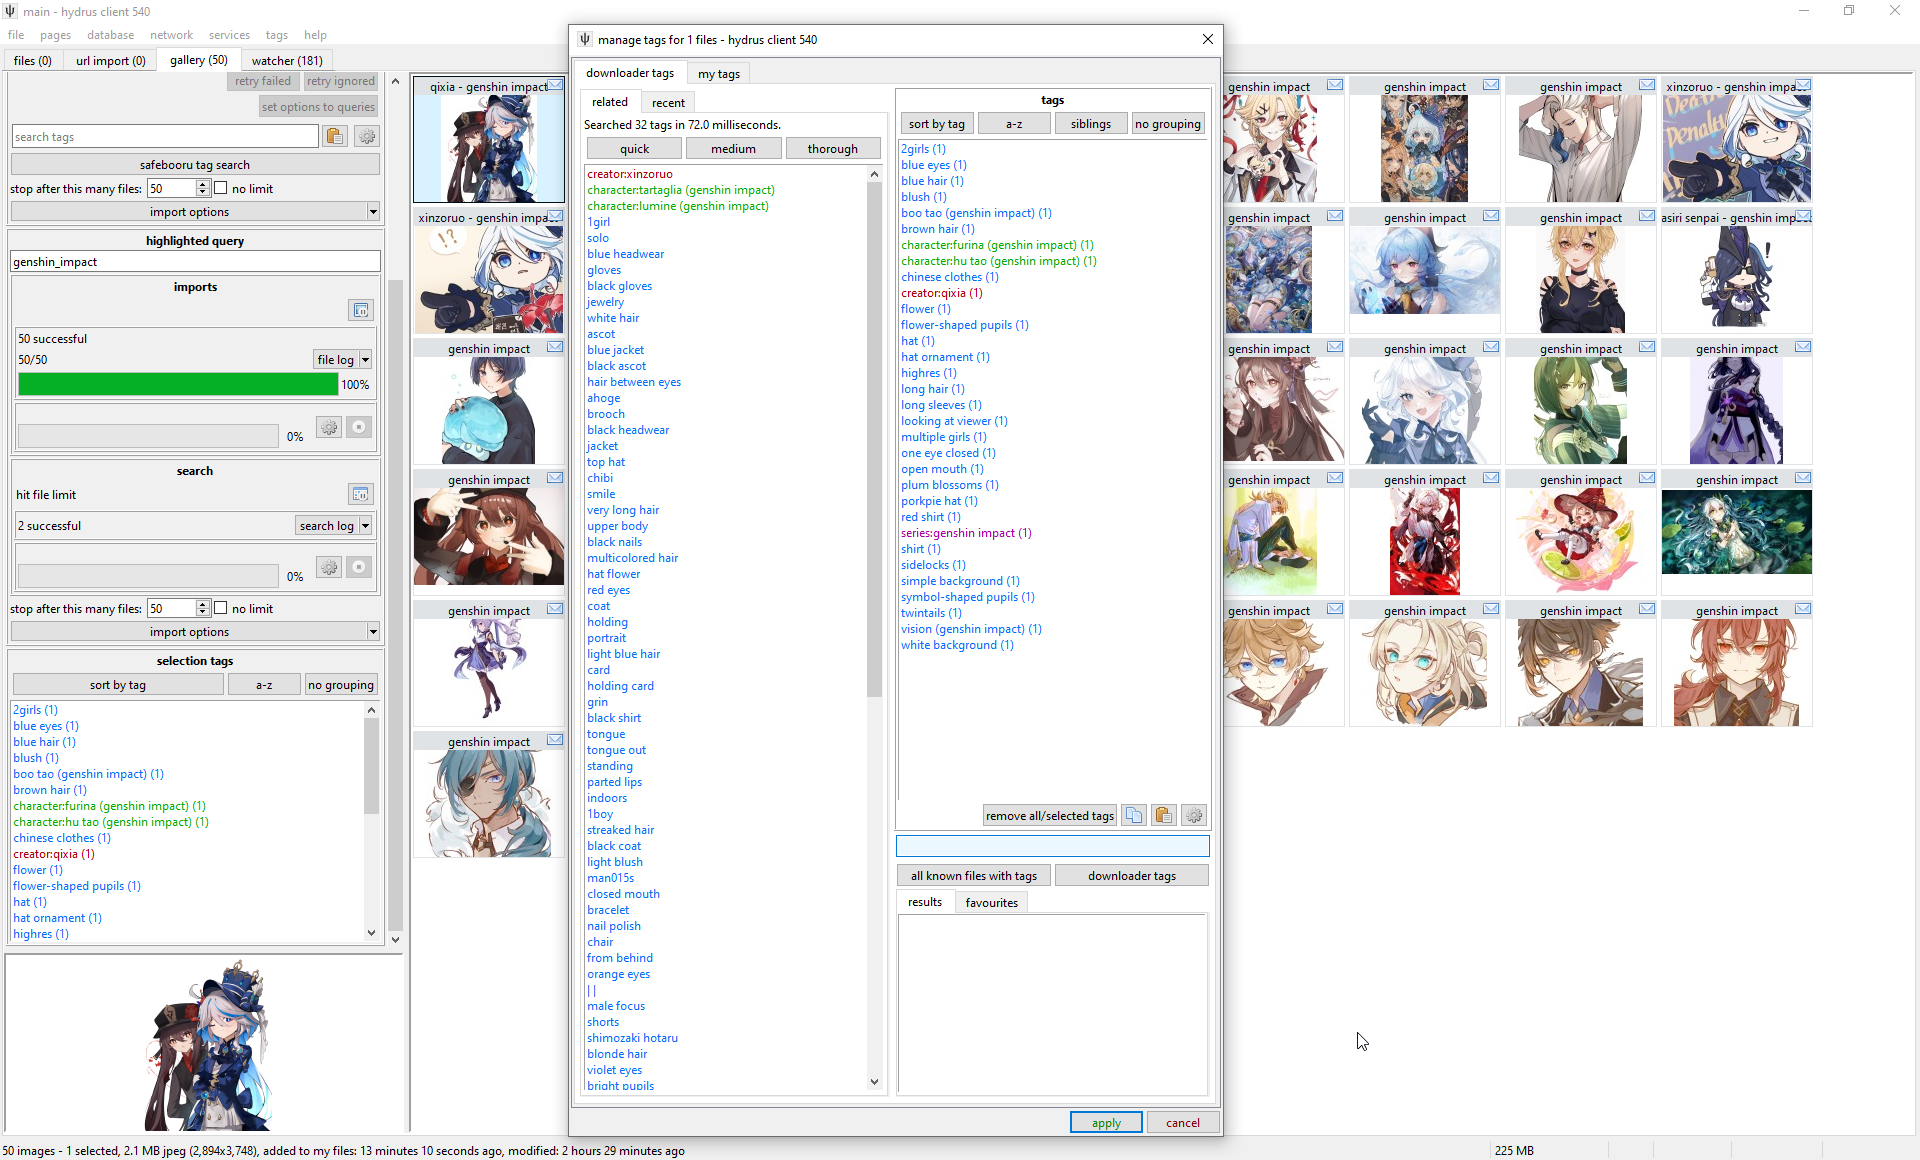
По умолчанию локальные установки используют как минимум сервисы my tags и downloader tags. Первый удобно оставить для собственной ручной разметки, второй — для автоматически полученных тегов сайтов. Через services -> edit можно создавать дополнительные локальные tag services. Это не просто декоративные категории: поиск способен ограничивать область тегов, а правила импорта могут направлять разметку в разные сервисы.

Хорошая схема тегов развивается от реальных запросов. Если пользователь никогда не ищет по цвету фона, тратить часы на background:red для каждого изображения бессмысленно. Напротив, если коллекция регулярно разбирается по источнику, автору и статусу обработки, эти три оси стоит закрепить с самого начала. Hydrus не заставляет принять единую онтологию, но цена полной свободы — необходимость поддерживать собственные соглашения.
Tag siblings: синонимы и исправление вариантов
Tag siblings задают отношение вида A → B: разные варианты одного понятия отображаются и ищутся как предпочтительный B. Это полезно для опечаток, разных порядков имени, транслитерации и перехода на новую схему тегов. Связи транзитивны, поэтому A → B и B → C в итоге приводят A к C. Один исходный тег не должен иметь несколько конкурирующих «идеальных» целей, и циклы запрещены.
Управление находится в tags -> manage tag siblings. Важно, что Hydrus не уничтожает исходное знание: связь влияет на представление и поиск, а исходный тег сохраняется в данных. Если удалить sibling relationship, прежние варианты снова становятся видимыми. Поэтому механизм лучше массового ручного переименования, когда требуется обратимая нормализация.
Использовать siblings стоит только для действительно эквивалентных понятий. Связь car -> vehicle ошибочна: автомобиль — частный случай транспортного средства, а не синоним. Для иерархии предназначены parents. Неправильное смешение этих двух систем приводит к слишком широким результатам и затрудняет понимание, почему конкретный файл появился в выдаче.
Tag parents: иерархия без физического копирования тегов
Tag parents описывают импликацию «дочерний тег означает родительский». Если character:x принадлежит series:y, поиск по серии может автоматически включать файлы персонажа. Родительские теги в Hydrus виртуальны: система ведёт отношение и показывает следствие, но не обязана физически записывать родителя на каждый файл. Удаление связи убирает и виртуальное следствие.
Диалог открывается через tags -> manage tag parents. Одному дочернему тегу разрешено иметь несколько родителей, а цепочки могут образовывать несколько уровней. Циклы, как и у siblings, не допускаются. Изменение крупной схемы родителей может потребовать фонового пересчёта, поэтому на большой базе результат не обязательно обновится мгновенно.
Практический пример — создать локальный сервис для субъективных групп и связать десятки creator-тегов с родителем favourite:aesthetic_art. Тогда вместо длинного OR-запроса по всем авторам можно искать один родительский тег. Такая схема остаётся локальной и не требует загружать субъективную классификацию в публичный репозиторий.
Поиск: предикаты вместо просмотра папок
Новая поисковая страница создаётся через меню страниц или через сочетание Ctrl+T с выбором file search. Строка поиска предлагает теги по мере ввода, но Hydrus рассматривает условия шире: любой элемент запроса называется predicate. Помимо обычных тегов существуют системные предикаты — тип файла, размер, длительность, состояние inbox/archive, рейтинг, наличие URL, дата импорта, ограничения количества результатов и другие свойства.
Базовый поиск — это пересечение условий. Если добавить creator:alpha и series:beta, в выдаче останутся объекты, удовлетворяющие обоим предикатам. Условия можно отрицать, использовать wildcard со знаком *, а в расширенном режиме собирать OR-группы. Для сложных запросов лучше не набирать длинные конструкции вслепую, а добавлять предикаты по одному и следить, как меняется размер выборки.
Поисковая страница также имеет file domain и tag domain. Первый определяет, где искать файлы — например, среди локальных материалов или иной доступной области. Второй задаёт, какие tag services участвуют в интерпретации тегов. Это важная причина, по которой «я точно назначил тег, но поиск ничего не показывает» не всегда означает потерю данных: запрос может смотреть в другой tag domain или исключать pending/current состояния.
Часто используемые запросы можно сохранять как favourites. Для потока обработки это эффективнее ручного повторения. Например, запрос system:inbox + конкретный creator + system:limit=256 формирует небольшую пачку необработанных файлов одного автора. После архивации этих объектов тот же favourite при следующем запуске выдаст следующую порцию.
Wildcard, OR и редактирование предикатов
Wildcard полезен, когда нужно искать группу тегов по части текста или namespace. Внутренний поиск нормализует некоторые варианты пробелов, подчёркиваний и пунктуации, поэтому точное воспроизведение внешнего написания не всегда требуется. Для OR можно создать группу условий через расширенный интерфейс; в соответствующем режиме Shift используется для добавления альтернатив. Уже добавленный предикат можно открыть для редактирования через контекстное действие, вместо удаления и повторного набора.
OR-запросы удобны, но не должны заменять хорошо устроенную иерархию. Если один и тот же набор из сорока авторов постоянно вставляется в десятки запросов, локальный parent-тег обычно проще сопровождать. Если OR нужен однократно, создавать постоянную таксономию ради него, наоборот, излишне.
Сортировка, collect и system:limit
Результаты можно сортировать независимо от условий поиска. Помимо стандартных свойств поддерживаются сортировки по namespace. Пользовательские namespace sorts настраиваются в параметрах file sort/collect. Функция collect группирует миниатюры в коллекции по тегам определённого пространства либо по rating service; это позволяет, например, собрать в одной сетке группы по автору без изменения исходных данных.
system:limit ограничивает объём выдачи и особенно полезен в постоянных рабочих страницах. Следует учитывать порядок операций: для некоторых простых сортировок Hydrus может сначала выбрать нужный порядок и затем применить limit, а для сложной сортировки по тегам ограниченная выборка может сначала быть получена как часть общего результата и сортироваться уже после. Если требуется гарантированно «самые новые 256 файлов», нужно проверить, что выбранная сортировка поддерживает ожидаемый порядок до ограничения.
Inbox, archive и корзина
Новые импортированные файлы по умолчанию попадают в inbox. Это не отдельная папка, а статус, который можно искать предикатом system:inbox. После принятия решения файл переводится в archive. Клавиша F7 архивирует выбранные материалы, Shift+F7 возвращает их в inbox. Такая двухступенчатая модель хорошо подходит для потока: загрузчики могут работать в фоне, а пользователь периодически открывает ограниченную выборку inbox и разбирает её.
Удаление отправляет объект в локальную корзину Hydrus, которая сама является поисковой областью. Это позволяет исправить свежую ошибку, пока файл не удалён окончательно согласно настройкам обслуживания корзины. Delete выполняет обычное удаление, а Shift+Delete в соответствующем контексте используется для восстановления из trash. Поведение горячих клавиш может зависеть от активного окна, поэтому перед массовой обработкой полезно проверить действие на нескольких тестовых файлах.
Для последовательной обработки существует archive/delete filter. Выделите набор миниатюр и запустите filter -> archive/delete или назначенную клавишу F12. Фильтр показывает материалы один за другим: левое действие или F7 архивирует, правое/Delete удаляет, Up пропускает, Backspace либо средняя кнопка возвращает предыдущий шаг. Решения фиксируются при завершении фильтра. Режим полезен тем, что превращает хаотическое щёлканье по сетке в однозначную очередь решений.
Лучше разделять критерии «плохой файл» и «я пока не решил». Inbox как раз хранит вторую категорию. Если сомнительный материал сразу удалять, позже придётся восстанавливать его через корзину или повторный импорт. Если же оставлять всё навечно в inbox, статус теряет смысл. Практичная схема — inbox означает «ещё не просмотрено», archive — «решение принято, оставить», trash — «не нужен».
Рейтинги и пользовательские шкалы
Hydrus поддерживает несколько типов rating services, включая like/dislike и числовые оценки; в актуальном клиенте также существуют счётчики. Новый локальный рейтинг создаётся через services -> edit. Для выделенных файлов окно оценки открывается клавишей F4. Рейтинг затем участвует в поиске через системные предикаты и может использоваться для сортировки или collect.
Рейтинги и теги решают разные задачи. Тег quality:good технически возможен, но rating service удобнее там, где значение лежит на одной шкале и часто меняется. Теги лучше описывают сущность и принадлежность: автор, серия, вид сцены, источник. Смешение подходов не запрещено, однако заранее определённая роль рейтинга делает запросы проще.
Если нужно несколько независимых оценок, можно создать отдельные сервисы — например, «личное избранное» как like/dislike и «качество источника» как числовой рейтинг. Это точнее, чем пытаться выразить разные критерии одной пятибалльной шкалой. При экспорте следует заранее проверить, какие рейтинги должны переноситься и поддерживает ли выбранный sidecar-сценарий нужное представление.
Загрузка из интернета: не один встроенный парсер, а система загрузчиков
Hydrus умеет получать файлы с сайтов, но свежая установка не должна восприниматься как браузер со списком гарантированно работающих источников. Загрузчики — пользовательские конфигурации, которые можно импортировать, экспортировать и обновлять независимо от самого клиента. Они описывают URL Classes, правила парсинга, генераторы галерейных URL и связанные объекты. Когда сайт меняет разметку или API, соответствующий загрузчик может перестать работать до обновления.
Импорт готовых конфигураций выполняется через network -> downloaders -> import downloaders. Объекты Hydrus могут распространяться в виде сериализованного JSON или специально подготовленного PNG-контейнера. Перед массовой загрузкой с нового сайта полезно проверить один запрос на небольшой лимит: убедиться, что открываются нужные страницы, извлекаются ожидаемые теги и скачивается именно оригинальный файл, а не превью.
Основные типы сетевых задач — Gallery, Subscriptions, Watcher, URL downloader и Simple downloader. Они разделены не для красоты: у каждого своя модель входных данных и повторения. Gallery проходит результаты поисковой галереи, Subscription периодически повторяет запрос, Watcher следит за меняющейся страницей вроде треда, URL downloader работает со списком конкретных URL, а Simple downloader применяет простую формулу к одной странице.
Gallery downloader: ручной запрос к источнику
На странице Gallery выбирается источник, вводится запрос и задаётся stop file limit. Можно запускать несколько строк запрос/источник и видеть состояние каждой. Выделение строки показывает связанные с ней результаты и детали очереди. Такой режим подходит для разовой загрузки архива автора, тега или диапазона, когда пользователь хочет контролировать границу работы и сразу видеть, что происходит.
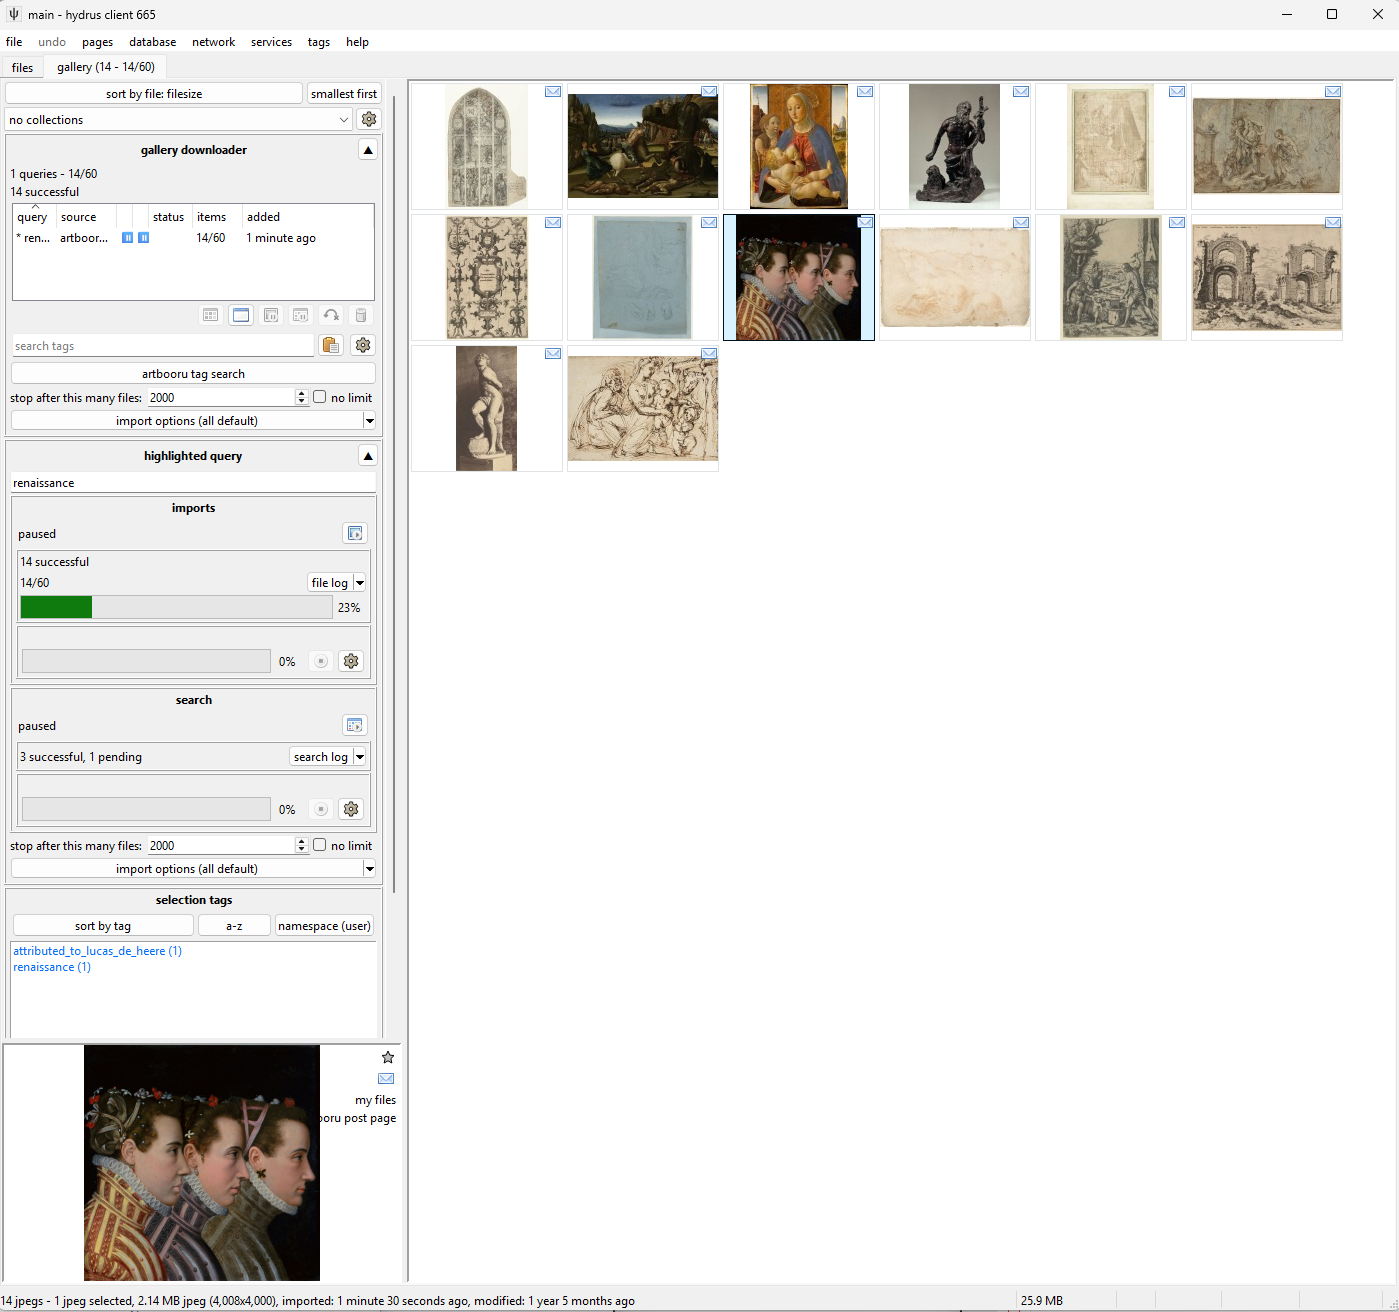
Stop file limit ограничивает число найденных/обрабатываемых файлов в конкретной задаче и служит страховкой от неожиданно огромной выдачи. Для первого теста лучше поставить небольшой предел, проверить теги и качество файлов, а затем расширять очередь. Hydrus рассчитан на длительные фоновые загрузки, а не на максимальную скорость любой ценой; слишком агрессивная постановка десятков тысяч URL одновременно увеличивает нагрузку на интерфейс и разбор метаданных.
Если после настройки тегов повторный запуск той же галереи быстро проходит со статусом already in db, это нормальная оптимизация: клиент знает соответствие URL и файла и не тратит сеть на повторный запрос страницы. Когда цель — именно заново получить метаданные, используйте для выделенных файлов urls -> force metadata refetch или временные Prefetch Import Options с принудительным запросом метаданных. Не делайте принудительный refetch постоянным глобальным правилом: он отменяет полезную экономию запросов.
URL downloader и drag-and-drop ссылок
URL downloader получает список конкретных ссылок и обрабатывает их по очереди. В поле можно вставить несколько URL, разделённых переводами строк. Распознаваемую ссылку также можно перетащить из браузера в клиент. Если URL относится к watchable-типу, Hydrus способен направить его в watcher; обычные ссылки попадут в URL downloader согласно настроенной классификации.
Этот режим не заменяет Gallery для многостраничного поиска. URL downloader не должен искусственно «листать» галерею, потому что его модель — независимые известные адреса. Если пользователь пытается вставить URL страницы поиска и ожидает автоматического перехода к следующей странице, нужен соответствующий Gallery URL Generator и галерейный загрузчик.
Watcher: отслеживание меняющейся страницы
Watcher предназначен для страниц, где новые файлы появляются в рамках одного продолжающегося URL, например тредов. Проверки выполняются повторно с адаптивным интервалом, а уже известные элементы не импортируются заново. Это отличается от подписки: подписка повторяет поисковый запрос и получает новые результаты галереи, watcher проверяет одну и ту же watchable-страницу.
Если источник перестаёт обновляться, checker постепенно увеличивает интервал и в конечном итоге может считать задачу завершённой/DEAD согласно своим правилам. Изменять эти параметры стоит только при реальной проблеме — например, если конкретный сайт обновляется необычно редко и Hydrus преждевременно прекращает проверку.
Simple downloader
Simple downloader полезен для одноразовых страниц, где нужно забрать все изображения или цели ссылок по простой формуле. Он не обладает всей логикой полноценного site downloader, но быстрее настраивается для необычной статической страницы. Если задача повторяется или требует извлечения сложных метаданных, лучше создать полноценные URL Class/Parser/GUG объекты, чем наращивать хрупкую простую формулу.
Пропускная способность и сетевые ограничения
Hydrus сознательно ограничивает частоту сетевых запросов. Правила доступны через network -> data -> review bandwidth usage and edit rules. Они применяются по нескольким контекстам: глобально, по домену и для конкретного типа работы вроде страницы загрузчика, подписки или watcher. Сетевой запрос стартует только тогда, когда все относящиеся к нему контексты разрешают работу.
Консервативные значения защищают одновременно источник и локальный клиент. В документации указано базовое ограничение, не позволяющее обращаться к одному домену чаще примерно одного раза в секунду. Дополнительные дневные или периодические правила могут останавливать очередь заметно дольше. Сообщение вроде bandwidth free in ... поэтому не означает зависание: программа сообщает, что один из контекстов пока исчерпал допустимый бюджет.
Отключать все ограничения ради «ускорения» — плохая диагностика. Это может повысить нагрузку на CPU, диск и интерфейс, а удалённый сайт способен ограничить или заблокировать слишком частые запросы. Если задача объективно должна идти быстрее, сначала откройте панель review, определите, какой именно контекст блокирует очередь, и меняйте только его правило. Такой подход сохраняет глобальную защиту для остальных источников.
Подписки: регулярное получение новых результатов
Подписка связывает источник загрузчика с одним или несколькими поисковыми запросами и периодически проверяет их. Создание и редактирование выполняется через network -> manage subscriptions. Для обычного случая достаточно имени, источника и списка query. После сохранения просроченные проверки запускаются, а найденные новые URL проходят обычную очередь импорта.
Подписка не предназначена для первичного выкачивания огромной истории. Сначала разумнее сделать ручной Gallery download с контролируемым лимитом и убедиться, что архивная часть получена. После этого подписка поддерживает поток свежих публикаций. Иначе начальная синхронизация может превратиться в многотысячную очередь, которую труднее диагностировать и которая мешает другим задачам.
Hydrus использует историю запросов, чтобы оценивать интервал следующей проверки. Если долго нет новых результатов, запрос проверяется реже и в конце может перейти в DEAD. В документации типовое окно для признания долго не обновляющейся галереи «мёртвой» измеряется месяцами; точное значение определяется checker options. Возвращать такой запрос нужно осознанно, если источник действительно снова активен.
Результаты подписки можно публиковать не только всплывающей кнопкой, но и на постоянную страницу. Для нескольких подписок удобно создать page of pages, например subs, и направлять каждую в собственную или общую landing page. Это отделяет фоновое получение от момента просмотра: клиент собирает новые файлы, а пользователь разбирает их тогда, когда удобно.
По умолчанию presentation для подписок ориентирован на новые файлы и не должен засорять поток объектами, уже присутствующими в базе. Они всё равно учитываются в истории запроса и расчёте следующей проверки. Если после изменения сайта сразу несколько подписок начинают выдавать ошибки или быстро доходят до periodic limit, вероятная причина — сломанный downloader. В таком случае безопаснее поставить затронутые подписки на паузу, проверить тот же запрос вручную в Gallery и обновить конфигурацию загрузчика.
Логины и cookies: что учитывать
У клиента есть собственная система login scripts, но официальная документация прямо предупреждает, что она старая, ограниченная и не хранит важные учётные данные с уровнем защиты, подходящим для критичных аккаунтов. Для источников, где без авторизации нельзя получить нужный контент, разработчик советует не связывать Hydrus с ценными учётными записями. Если используется отдельная техническая учётная запись, риски блокировки и компрометации не затрагивают основной аккаунт.
Сессионные cookies можно импортировать в соответствующий сетевой диалог, в том числе из формата cookies.txt, если внешний инструмент сформировал совместимые данные. Это позволяет Hydrus действовать в рамках уже установленной браузером сессии без попыток автоматизировать сложный современный login flow. Но cookies фактически являются ключами сессии, поэтому резервные копии и экспорт конфигураций с ними нельзя раздавать как обычные загрузчики.
Хранение, хэши и связь метаданных с файлами
После импорта Hydrus привязывает метаданные не к исходному имени, а к внутренней записи файла. Центральный идентификатор — криптографический хэш содержимого. Благодаря этому переименование исходника до импорта или совпадение имён у разных файлов не создаёт двусмысленности. И наоборот, два бинарно одинаковых файла с разными названиями распознаются как один и тот же объект.
Такое устройство особенно полезно для веб-коллекций. Один файл может встречаться на нескольких сайтах и иметь несколько известных URL. Hydrus способен связать все эти адреса с одной записью и не плодить точные копии. Теги, рейтинги и заметки остаются привязаны к объекту базы, а не к тому, под каким именем он когда-то был скачан.
Внутреннее хранилище не предназначено для ручной сортировки. Каталоги и имена внутри него технические, поэтому перенос отдельного файла оттуда в Explorer/Finder не является корректным способом экспорта. Используйте контекстные команды share -> export -> files, копирование файлов или drag-and-drop из Hydrus: тогда программа сама отдаёт нужный объект и может сформировать осмысленное имя, структуру подпапок и sidecar.
Если важна совместимость с внешним каталогизатором, заранее определите границу ответственности. Один вариант — Hydrus хранит мастер-копию, а наружу периодически экспортируются выбранные наборы с sidecar. Другой — основная библиотека остаётся файловой, а в Hydrus импортируется рабочая копия для поиска и веб-загрузок. Попытка одновременно считать внутреннее хранилище Hydrus и внешнее дерево папок одной редактируемой библиотекой приводит к рассинхронизации.
Поддерживаемые форматы и просмотр
Клиент работает не только с JPEG и PNG. Актуальная документация перечисляет широкий набор изображений, включая GIF, WebP, AVIF, JPEG XL, BMP, HEIC/HEIF, TIFF и другие форматы, а также видео, аудио и некоторые файлы графических проектов. Поддержка при этом неодинакова: один формат полноценно декодируется и показывается в media viewer, другой может иметь превью, а третий лишь хранится в базе и открывается внешней программой.
Например, документы вроде PDF могут быть известны базе и участвовать в поиске, но не обязаны отображаться внутри клиента так же, как обычная картинка. Для таких типов предусмотрен запуск через системную программу. Поэтому перед импортом необычной коллекции — PSD, Krita, EPUB, офисных документов — полезно проверить не только строку «поддерживается», но и конкретный уровень: распознавание типа, извлечение размеров/превью, собственный просмотр и внешний запуск.
Видео и аудио воспроизводятся через встроенные механизмы с использованием mpv либо нативного Qt-плеера в зависимости от настроек и платформы. Если конкретный кодек не открывается, проблема может быть не в базе и не в импорте, а в декодировании. Не удаляйте файл как «битый», пока не проверили его во внешнем плеере и не изучили сообщения клиента.
Для коллекции исходников графических редакторов полезно хранить проект и экспортный рендер как отдельные файлы, а затем связать их тегами или relationship-механизмом. Автоматически считать PSD и JPEG дубликатами только потому, что визуально они похожи, опасно: проект содержит слои и другие данные, которых нет в рендере. В правилах автоматической обработки дубликатов разработчик отдельно советует ограничивать поиск обычными изображениями, чтобы богатые проектные форматы не попадали под примитивные правила удаления.
Поиск похожих файлов и система дубликатов
Точный хэш решает только задачу бинарных копий. Для визуально похожих изображений Hydrus вычисляет перцептивный хэш и строит структуру, позволяющую искать пары по расстоянию между такими отпечатками. В документации описывается 64-битный pHash и поиск по Hamming distance. Чем больше допустимое search distance, тем шире множество кандидатов и тем выше риск ложных совпадений.
Работа начинается на странице duplicates processing. Сначала клиент подготавливает данные похожести, затем ищет potential duplicates в выбранной области. Для первого прохода разработчик рекомендует начинать с search distance 0 и повышать значение осторожно; практически полезные значения обычно находятся в небольшом диапазоне, а рост дистанции быстро добавляет пары, которые лишь отдалённо напоминают друг друга.
Hydrus различает несколько отношений. Duplicates — версии, которые считаются одним и тем же содержанием с возможной разницей качества. Alternates — связанные изображения, изображающие одно и то же или происходящие из одного источника, но не являющиеся взаимозаменяемыми копиями. Potential duplicates — ещё не решённые пары, найденные алгоритмом. Эта терминология важнее привычного слова «похожее»: от выбранного отношения зависит, как программа будет показывать и обрабатывать пары дальше.
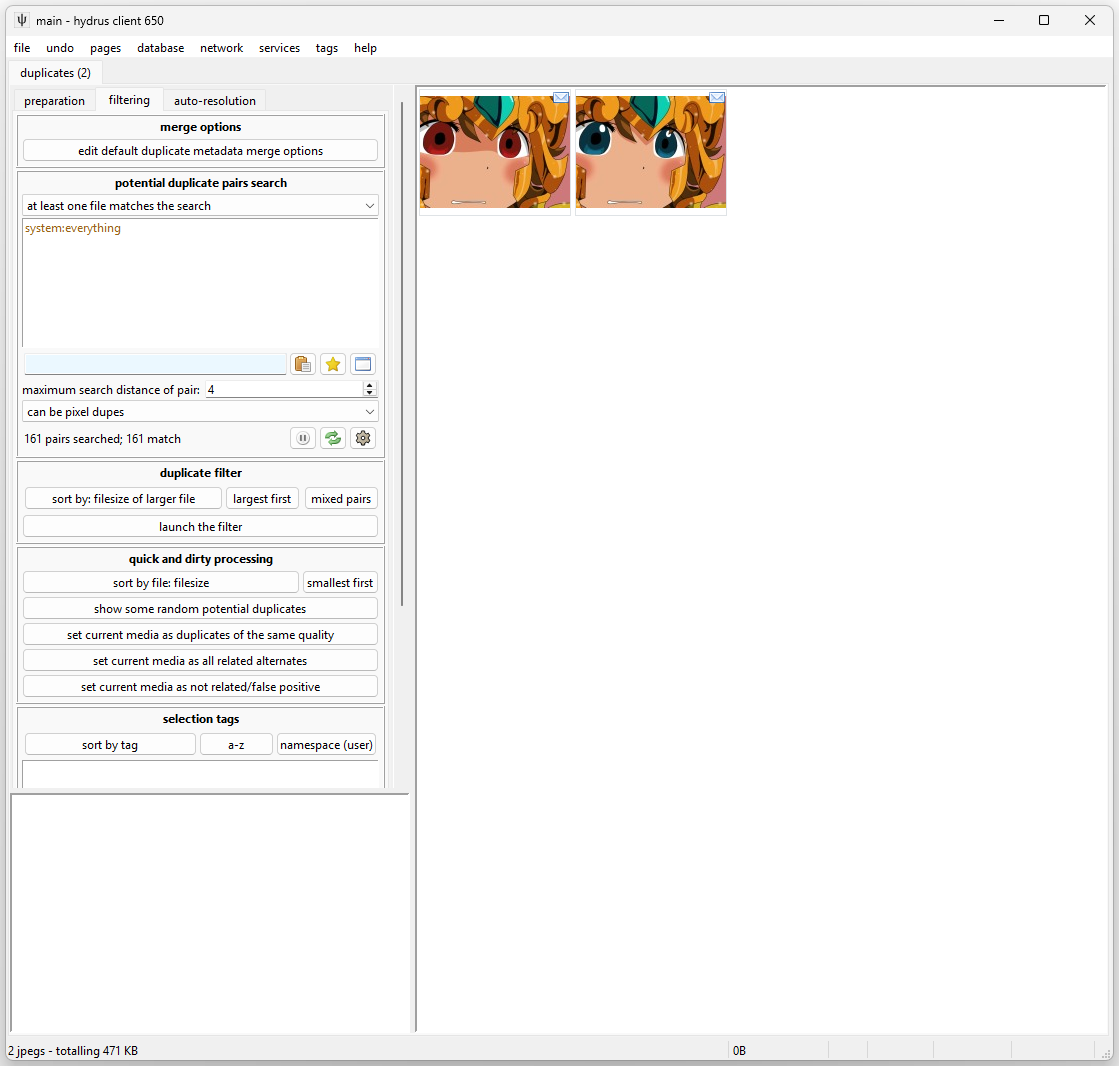
На странице можно ограничить поиск обычными предикатами, выбрать максимальную дистанцию, работать только с pixel duplicates и разделять наборы. Чем точнее поисковая область, тем меньше бессмысленной работы. Если библиотека содержит иллюстрации, фотографии и сканы документов, имеет смысл запускать отдельные очереди с подходящими условиями, а не сравнивать каждый файл со всей базой.
Duplicate filter: принятие решения по паре
Кнопка launch the filter открывает последовательность найденных пар. В просмотрщике две версии сравниваются в согласованных позициях и масштабе, чтобы переключение между ними не требовало заново искать одинаковую область. Панель показывает свойства, по которым одна версия может быть лучше: разрешение, размер файла, наличие метаданных и другие признаки. Цветовые подсказки — помощь, а не автоматический приговор.
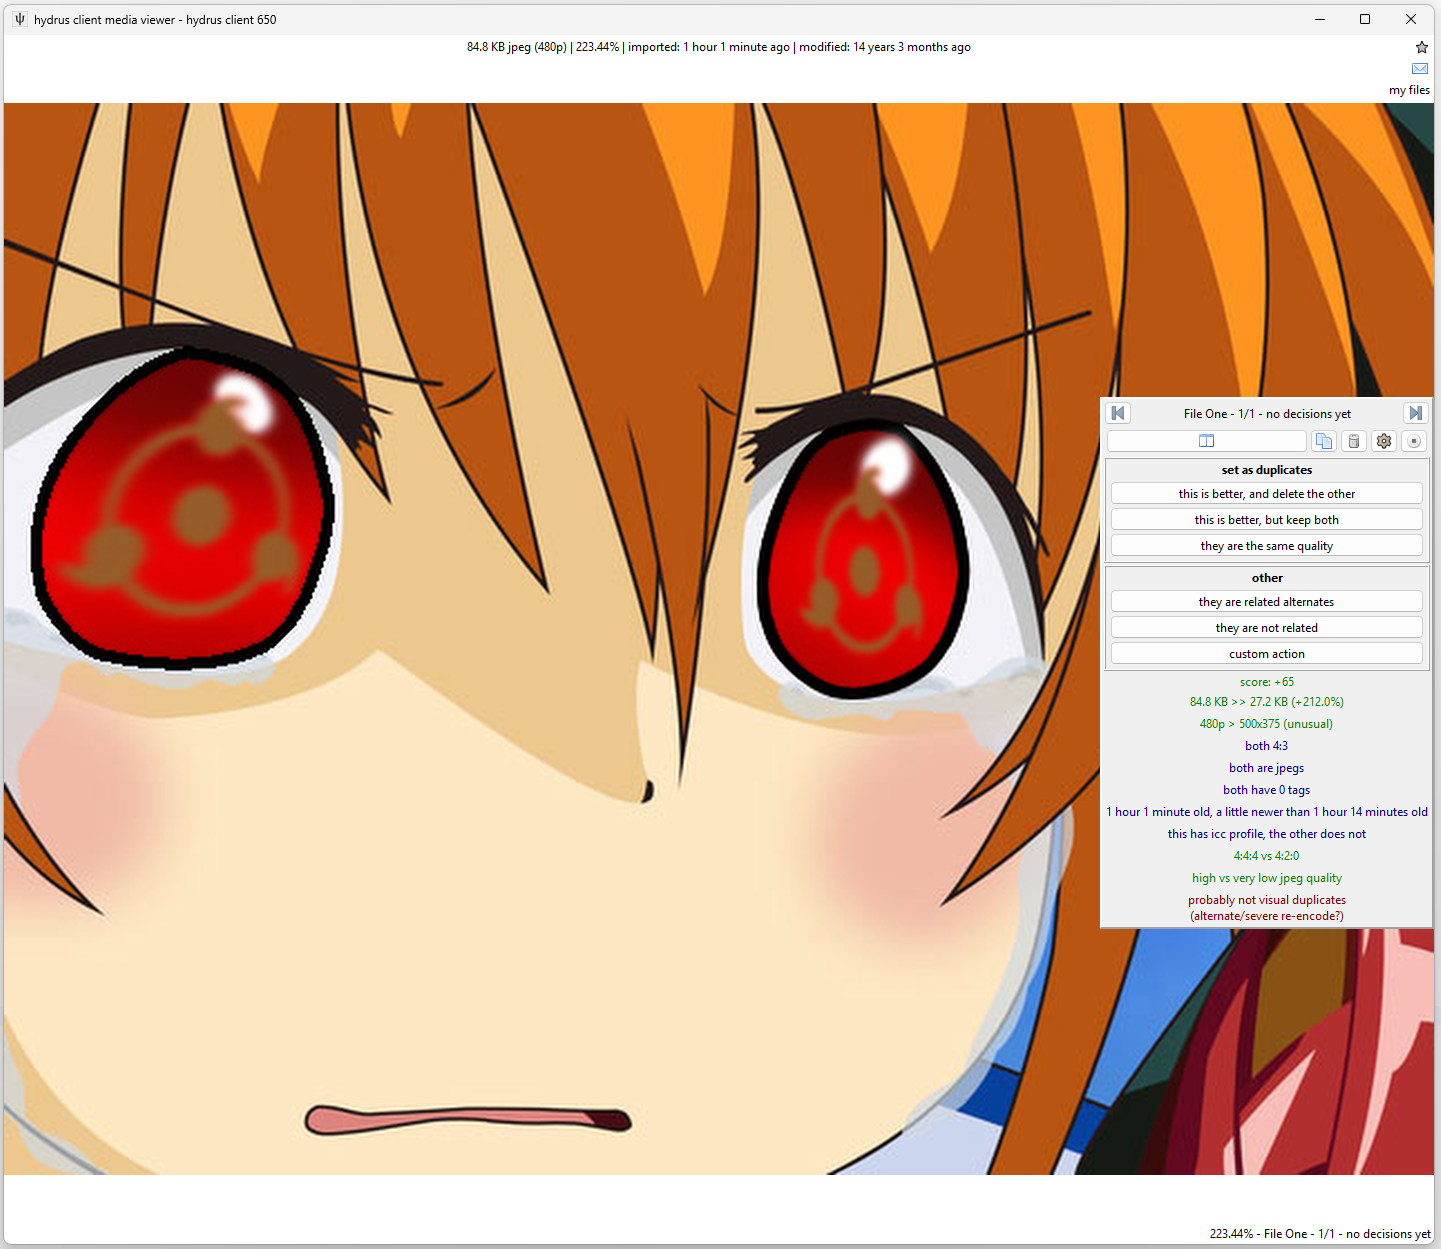
Основные решения включают «этот файл лучше», «другой лучше», «одинаковое качество» и «alternates». При выборе лучшего файла Hydrus может удалить худший и одновременно перенести метаданные согласно merge options. Для повторяющейся работы полезно заранее настроить, должны ли объединяться теги, рейтинги, URL, заметки и статус archive. Иначе можно аккуратно выбрать лучший JPEG, но неожиданно потерять полезный тег, который был только на второй версии.
Фильтр позволяет вернуться на предыдущую пару и завершить очередь без обработки остатка. Это важнее, чем кажется: если после десятка сравнений выяснилось, что search distance слишком широк и большинство пар ложные, лучше остановиться, сузить поиск и пересчитать кандидатов, а не продолжать из инерции.
Pixel duplicates и визуально похожие версии
Pixel duplicate означает совпадение отрисованных пикселей, но не обязательно бинарное равенство. Два файла могут иметь одинаковое изображение и различаться контейнером, метаданными или сжатием. В таком случае решение «оставить один» обычно проще, но всё равно надо учитывать EXIF, XMP, ICC-профиль и прочие данные, которые не видны на экране.
При ненулевом pHash distance пары становятся субъективнее: ресайз, лёгкая коррекция, водяной знак, кроп или изменение цвета могут быть обнаружены как похожие. Здесь relation alternate нередко точнее, чем duplicate. Например, кадр с подписью и чистый оригинал могут относиться к одному произведению, но пользователь может хотеть сохранить оба как самостоятельные варианты.
Автоматическое разрешение дубликатов
Для повторяемых очевидных случаев есть duplicates auto-resolution. Правило состоит из поиска пары, проверки того, как расположить стороны A и B, и действия. В официальной справке в качестве учебного сценария приводятся pixel-perfect JPEG/PNG пары. Для нового правила разумно использовать semi-automatic режим: программа подготовит решения, но пользователь подтвердит их через pending actions.
Fully automatic подходит только после того, как критерий доказал предсказуемость на собственной коллекции. Нельзя переносить чужую установку «больший файл всегда лучше» на все форматы: размер может расти из-за лишних метаданных, другого кодека или неэффективного контейнера. Особенно опасны правила, затрагивающие проектные файлы, небольшие иконки, сканы или изображения с ценными профилями.
В preview правила показываются пары, которые проходят или не проходят условия, и предполагаемые изменения контента. Если порядок A/B двусмысленен, нельзя использовать действие типа «A лучше B» без дополнительного критерия. Для автоматизации удалений стоит привязать запуск к расписанию резервного копирования: undo существует, но он не обязан полностью откатить уже выполненное слияние метаданных.
Экспорт файлов и формирование имён
Выделенные материалы можно экспортировать через контекстное меню share -> export -> files. Другие быстрые варианты — копирование файлов или drag-and-drop из сетки во внешнюю папку. В отличие от ручного доступа к client_files, экспорт понимает объекты базы и способен использовать шаблон имени, теги и sidecar-описания.
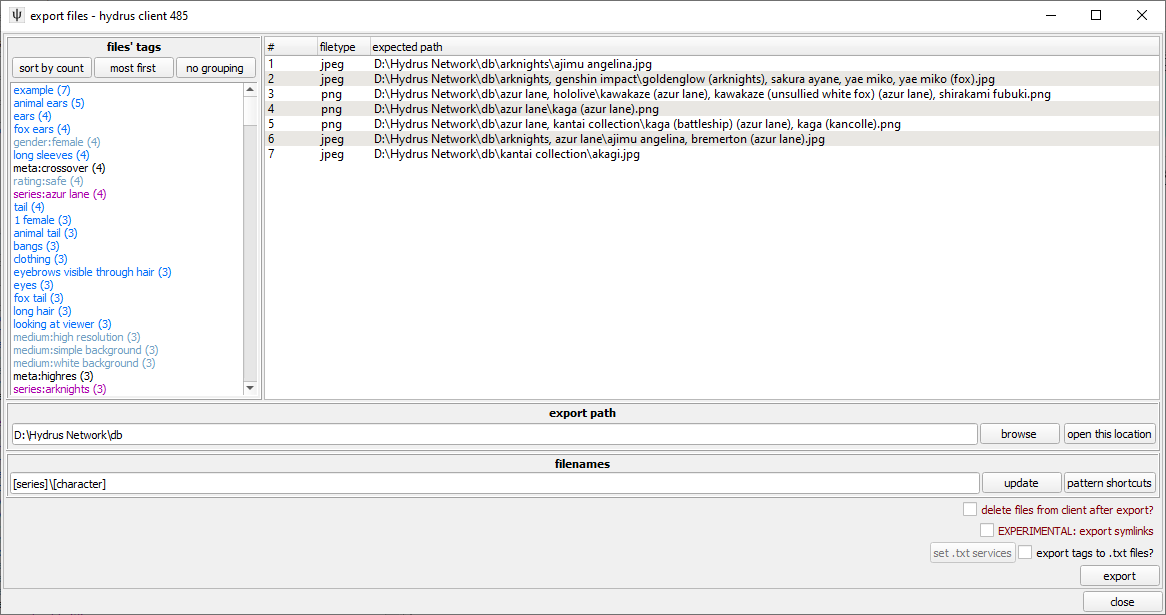
В окне экспорта задаётся каталог назначения и шаблон filename pattern. В шаблон можно подставлять свойства файла и теги, а разделители позволяют строить подпапки. Это удобно для публикации отдельной части коллекции в более традиционной структуре: например, сгруппировать результат по creator namespace, не меняя внутреннюю организацию Hydrus.
Перед экспортом тысяч файлов проверяйте preview итогового пути на нескольких примерах. Особенно внимательно относитесь к тегам, которые содержат символы, недопустимые в именах файлов конкретной ОС, и к случаям, когда у объекта отсутствует ожидаемый namespace. Хороший шаблон должен иметь безопасный fallback, чтобы два файла не получили одинаковое имя и чтобы «пустой автор» не создавал непредсказуемый путь.
Экспорт не удаляет внутренний объект. Это создание внешней копии для передачи, редактирования, публикации или резервного хранения. Если цель — освободить место в Hydrus после успешного вывода архива, это отдельная операция, которую лучше выполнять только после проверки экспортированной партии.
Sidecar-файлы: перенос тегов и URL рядом с медиа
Внутри своей базы Hydrus не нуждается в sidecar для хранения тегов: метаданные находятся в БД. Но при импорте и экспорте программа умеет работать с внешними sidecar. В актуальной документации описаны текстовые .txt и структурированные .json варианты; через правила можно передавать теги или URL и преобразовывать строки перед записью.
Sidecar полезен в двух сценариях. Первый — миграция: рядом с экспортированным изображением остаётся машиночитаемое описание, которое можно импортировать в другую систему. Второй — обмен между несколькими обработчиками: внешний скрипт создаёт теги или URL, а Hydrus подхватывает их при импорте. При этом формат надо считать частью контракта. Если одна программа ожидает по одному тегу в строке, а другая — JSON-массив, совпадение расширения ещё не гарантирует совместимость.
Настраивая экспорт, проверьте namespace и tag service. Тег из my tags и одноимённый тег из downloader tags может иметь разный уровень доверия. Экспортировать всё подряд нередко хуже, чем явно выбрать сервисы и пространства имён. Для повторяемого процесса сохраните конфигурацию, а не собирайте её заново перед каждой партией.
Автоматические Import/Export Folders
Через file -> import/export folders настраиваются папки, которые Hydrus периодически обрабатывает по правилам. Import Folder подходит для «входящего» каталога, куда другие приложения или синхронизация складывают новые файлы. Export Folder выводит выборку из базы в заданное место по настроенному шаблону.
Автоматизацию следует начинать с режима, не удаляющего входные данные. Сначала убедитесь, что фильтры, теги из имени/пути и действия после успешного импорта работают как задумано. Когда одна ошибочная регулярка способна пройти по тысячам файлов, возможность увидеть исходники после теста значительно важнее экономии нескольких гигабайт.
Для export folder нужно понимать, что внешний каталог — производное представление. Если пользователь вручную переименует или отредактирует там файл, Hydrus не обязан автоматически трактовать это как изменение внутреннего объекта. Если требуются двусторонние правки, лучше сформулировать отдельный процесс: экспорт → редактирование → импорт как новой версии.
Public Tag Repository и несколько tag services
Hydrus умеет работать с удалёнными tag repositories, но они не нужны для базовой личной библиотеки. Самый известный публичный репозиторий — PTR. Его смысл — совместно синхронизировать большое количество тегов и отношений между ними. Подключение такого сервиса резко отличается от создания ещё одного локального списка: требуется сетевой обмен и значительная локальная обработка данных.
Официальная документация предупреждает, что синхронизация крупного репозитория нагружает CPU и диск. Для очень большого набора тегов быстрый SSD заметно уместнее медленного диска. Если пользователю нужны только собственные несколько тысяч тегов, подключать огромный публичный словарь «потому что он есть» необязательно.
Несколько services помогают разделить доверие и назначение данных. Ручные теги можно хранить в my tags, автоматически полученные — в downloader tags, субъективные иерархии — в отдельном локальном сервисе, а общий публичный слой — в repository. Затем через настройки применения siblings/parents определяется, чьи отношения имеют приоритет в представлении.
При работе с удалённым репозиторием изменения могут иметь состояния pending/petitioned и требовать серверного подтверждения. Локальные теги такой модерации не имеют. Поэтому для персональной классификации, не предназначенной для сообщества, локальный сервис проще и безопаснее: он не создаёт споров о том, является ли конкретная иерархия универсально правильной.
Client API: интеграция со скриптами и внешними приложениями
Client API позволяет внешней программе обращаться к запущенному Hydrus: добавлять файлы и URL, искать записи, читать метаданные, назначать теги, рейтинги и заметки, а также работать с некоторыми отношениями. API выключен по умолчанию. Сервис добавляется через services -> edit, после чего задаётся порт и создаются ключи доступа с конкретными разрешениями.
По умолчанию API стоит использовать только локально. Разрешение внешних сетевых подключений превращает его в сетевой сервис, и тогда защита зависит от правильной конфигурации ОС, маршрутизатора и самого API. Документация предусматривает HTTPS с сертификатом, но сам факт шифрования не заменяет ограничение доступа. Если интеграция работает на том же компьютере, открывать порт в локальную сеть обычно незачем.
Каждому внешнему инструменту лучше выдать отдельный access key и минимальный набор прав. Скрипту, который лишь ищет файлы, не нужен доступ на удаление или изменение тегов. Если ключ утечёт, его можно отозвать без перестройки остальных интеграций. Принцип особенно важен для браузерных расширений и собственных утилит, которые часто обновляются независимо от Hydrus.
API активен, пока запущен клиент. Это не отдельный круглосуточный сервер базы. Поэтому автоматизация, которая ночью отправляет URL, должна либо обеспечивать запуск Hydrus, либо корректно обрабатывать недоступность сервиса. Для постоянного удалённого многопользовательского доступа существует отдельный server-компонент, но это уже другой сценарий и не требуется для обычной личной коллекции.
Производительность: где появляются реальные ограничения
Размер библиотеки и размер текущей страницы — разные нагрузки. Hydrus рассчитан на очень большие базы, и разработчик приводит примеры пользователей с сотнями тысяч файлов. Но попытка показать огромную долю коллекции в одном thumbnail grid нагружает GUI, сортировки и отслеживание изменений. Поэтому базу можно масштабировать дальше, чем отдельную рабочую страницу.
В официальном руководстве для страниц упоминается, что после примерно сорока тысяч одновременно отслеживаемых файлов интерфейс начинает заметно тяжелеть, а сессии порядка ста пятидесяти тысяч могут ощутимо тормозить. Это не гарантированные цифры для любого ПК: скорость зависит от CPU, памяти, диска, количества тегов, типов файлов и фоновых задач. Практический вывод один — ограничивать рабочие выдачи, а не пытаться держать «всё» открытым.
Для постоянных страниц хорош стартовый шаблон — конкретный предметный тег плюс system:limit=256 или другое разумное число. После обработки страницу можно обновить и получить следующую порцию. Это снижает стоимость сортировки, рендеринга миниатюр и массовых сигналов базы.
Импорт также использует CPU на каждый файл: распознаётся тип, вычисляются хэши, извлекаются свойства, создаются миниатюры и, для подходящих изображений, данные похожести. Одновременный запуск множества крупных downloader-очередей может сделать интерфейс дёрганым даже при свободной сети. В документации разработчик советует не превращать текущую сессию в склад десятков тысяч ожидающих URL; очередь лучше формировать управляемыми партиями.
Отдельная нагрузка возникает при siblings/parents и большом tag repository: изменение правил может вызвать пересчёт эффективного пространства тегов. Если после добавления крупной иерархии процессор занят, это не обязательно означает зацикливание. Дайте фоновой синхронизации закончить и не меняйте схему ещё пять раз подряд, иначе результаты промежуточных расчётов только усложнят диагностику.
Duplicate discovery — ещё один фоновой потребитель. Первичное построение данных похожести для старой коллекции и поиск пар могут идти долго. Сужение области поиска и маленькая pHash distance экономят больше времени, чем попытка «ускорить» задачу отключением других защит. Если база находится на SSD, случайные обращения и индексы обычно обслуживаются лучше, чем на медленном сетевом или архивном диске.
Резервное копирование и размещение базы
Резервировать нужно не только медиафайлы, но и базу: именно в ней находятся теги, URL, отношения, рейтинги и история решений. Простая копия части client_files не восстанавливает каталогизацию. Полноценная резервная копия должна захватывать весь рабочий каталог данных в согласованном состоянии.
Самый надёжный бытовой способ — закрыть клиент и копировать каталог данных, когда база не изменяется. Продвинутые схемы могут использовать снапшоты файловой системы, но тогда пользователь должен понимать гарантии конкретного инструмента. Синхронизация «на лету» по отдельным файлам SQLite без согласованного снимка рискует создать резервную копию, части которой относятся к разным моментам времени.
Активную базу не следует размещать на NAS только ради удобства копирования. SQLite ожидает локальную семантику блокировок, а задержка маленьких операций по сети способна резко ухудшить отзывчивость. Лучше держать рабочую базу локально и отправлять закрытую/согласованную копию на NAS как резерв.
Проверка backup важнее самого факта появления папки с датой. Периодически убедитесь, что размер копии реалистичен, в ней присутствует база и файловое хранилище, а носитель читается. Для особенно ценной коллекции полезно иметь как минимум одну копию на другом физическом устройстве.
Типичные проблемы и способы их разбирать
Импорт пишет already in db
Это штатный результат, если Hydrus уже знает хэш файла или уверенно связывает URL с существующим объектом. Если нужен сам файл, ничего делать не требуется. Если требуются обновлённые теги со страницы, выделите объект и используйте urls -> force metadata refetch. Принудительно скачивать бинарник заново ради метаданных обычно бессмысленно.
Файл помечен previously deleted
Клиент помнит, что этот хэш уже был удалён, и защищает от повторного появления. Если удаление было ошибочным, откройте import options конкретной задачи, переключитесь на custom и в File Filtering Import Options разрешите ранее удалённые файлы. Не отключайте фильтр глобально без причины.
После загрузки нет ожидаемых тегов
Сначала проверьте, какой Tag Import Options применялся и в какой tag service должны были попасть теги. Затем убедитесь, что downloader действительно парсит их с сайта. Если файлы уже известны базе, обычный повторный запуск может пропустить страницу и не получить новые метаданные; в таком случае нужен force metadata refetch. Если внешняя разметка попала в downloader tags, а поиск смотрит только my tags, данные присутствуют, но выбран другой tag domain.
Downloader внезапно перестал работать
Сайты меняют HTML, API и URL. Проверьте один небольшой запрос в Gallery, а не сразу все подписки. Если URL не распознаются или парсер не находит файлы, обновите объект downloader. На время диагностики поставьте подписки этого домена на паузу, чтобы они не создавали одинаковые ошибки и не исчерпывали лимиты.
Очередь пишет bandwidth free in… и не скачивает
Откройте network -> data -> review bandwidth usage and edit rules и найдите блокирующий контекст. Им может быть глобальный лимит, домен или отдельная очередь. Не обнуляйте все правила. Если ограничение слишком строго для конкретного доверенного сайта, меняйте только нужный контекст и наблюдайте за нагрузкой.
Поиск дубликатов выдаёт слишком много странных пар
Уменьшите search distance, начните с 0 и добавьте поисковые предикаты. Отдельно обрабатывайте pixel duplicates и визуально похожие версии. Не считайте любую найденную пару дубликатом: часть результатов корректнее пометить alternates или вообще исключить из связи.
Видео импортировалось, но не воспроизводится
Проверьте файл внешним плеером. Если он исправен, проблема вероятнее относится к декодеру или выбранному режиму воспроизведения, а не к базе. Не удаляйте объект только потому, что media viewer не смог его открыть. Для редких контейнеров можно использовать запуск внешней программой.
Клиент стал медленным после открытия большой страницы
Закройте или сузьте страницу, добавьте system:limit, уменьшите число одновременно открытых тяжёлых выборок. Если параллельно идут import, duplicate discovery и repository sync, дождитесь завершения фоновых задач. Масштаб всей базы не обязывает показывать всю базу в одном thumbnail grid.
После изменения siblings или parents поиск ведёт себя неожиданно
Проверьте, к какому tag service относится связь и где разрешено применять siblings/parents. Помните: sibling меняет идеальное представление эквивалентных тегов, parent добавляет виртуальное следствие. Если связь только что изменена на большой коллекции, дайте фоновому пересчёту завершиться.
После обновления первый запуск занимает много времени
Не завершайте процесс немедленно. Обновление может выполнять миграцию базы. Если переход был через много версий и клиент сообщает о недопустимом скачке, установите требуемую промежуточную версию согласно документации. Перед любым таким действием должна существовать резервная копия.
Файлы пропали после ручного вмешательства в client_files
Не продолжайте массово «чинить» структуру. Внутренние каталоги принадлежат Hydrus, и перемещение файлов ломает соответствие БД с реальным путём. Сначала остановите клиент, сохраните текущее состояние отдельной копией и используйте штатные recovery-инструкции. Возвращать сотни файлов наугад по именам — худший вариант.
Практический сценарий: перенос большой папочной коллекции
Если исходный архив годами раскладывался по каталогам, его не стоит импортировать целиком одним нажатием. Сначала возьмите небольшой репрезентативный фрагмент: несколько авторов, вложенные подпапки, разные форматы и несколько точных копий. Задача теста — понять, какие части пути действительно полезно превращать в теги и какие технические имена следует игнорировать.
- Создайте резервную копию исходной папки или убедитесь, что она уже существует на другом носителе.
- Запустите
file -> import filesи добавьте тестовую директорию. - В настройках тегирования из имени/пути извлеките только смысловые уровни. Не превращайте в теги служебные каталоги вроде
export,tempи датированные папки, если по ним никогда не будете искать. - Добавьте общий тег партии, например
migration:old_archive, чтобы тест легко находился и при необходимости удалялся. - Оставьте удаление оригиналов выключенным.
- После импорта проверьте несколько запросов, теги, дубликаты и открытие разных форматов.
- Только после этого переносите архив партиями удобного размера.
При таком подходе ошибку в схеме обнаруживают на сотне файлов, а не после дня импорта. Если выяснилось, что имя папки «2020» не должно было стать тегом, тестовую партию легко поправить. Если же неправильная логика уже применена к двумстам тысячам объектов, очистка лишней разметки превращается в отдельный проект.
Сохраняйте общий migration-тег до завершения проверки. Он позволяет сравнить число импортированных объектов с исходной партией, найти файлы без ожидаемого creator namespace и отдельно обработать случаи, которые программа отклонила как уже известные или ранее удалённые. После стабилизации схемы служебный тег можно снять массово.
Практический сценарий: постоянный поток изображений с сайтов
Для коллекционера, который регулярно следит за несколькими авторами или тегами, наиболее устойчивый процесс состоит из трёх этапов: ручная проверка downloader, начальная загрузка через Gallery и затем подписка только на новые публикации. Это лучше, чем сразу создавать сотни subscriptions и разбираться с ошибками уже в фоне.
Сначала импортируйте свежую конфигурацию загрузчика и выполните маленький запрос с stop file limit. Проверьте, что файл имеет ожидаемое разрешение, его URL связан с записью, а нужные внешние теги попадают в downloader tags или другой выбранный сервис. Если источник выдаёт много мусорной разметки, настройте Tag Import Options или фильтр namespace до массовой загрузки.
Затем используйте Gallery для исторической части. Определите разумный предел, дайте очереди пройти и разберите несколько десятков результатов. Когда достигнут нужный горизонт истории, создайте subscription с тем же источником и query. Подписка будет поддерживать актуальность, не пытаясь каждый раз повторять весь архив.
Новые файлы удобно направлять на постоянную landing page, а не оставлять в десятках всплывающих кнопок. На этой странице держите только свежие результаты и периодически прогоняйте archive/delete filter. Так сетевой сбор, принятие решения и долгосрочная библиотека становятся отдельными стадиями.
Если сайт меняется, первым симптомом часто оказывается не полная остановка клиента, а необычная серия ошибок в нескольких подписках. Не запускайте принудительный повтор всех запросов. Приостановите домен, проверьте один Gallery query, обновите downloader и только после успешного теста возобновляйте подписки.
Практический сценарий: разбор новой партии через inbox
Inbox позволяет превратить накопление файлов в управляемую очередь. Предположим, за неделю подписки и локальные импорты добавили несколько тысяч материалов. Запрос system:inbox покажет всё неразобранное, но открывать весь набор необязательно. Сохраните favourite с system:inbox и system:limit=256, а при необходимости добавьте creator или тип файла.
Откройте выборку, проверьте теги и запустите archive/delete filter. Хорошие материалы архивируйте, ненужные отправляйте в trash, спорные пропускайте. После окончания обновите favourite: уже архивированные объекты исчезнут из inbox, и на их место придёт следующая партия. Такой ритм сохраняет интерфейс лёгким и даёт измеримый конец каждой сессии.
Если пропущенные файлы начинают годами накапливаться, заведите для них дополнительный тег, например workflow:review_later, и убирайте из основного inbox только после осознанного решения. Не превращайте archive в «мне надоело смотреть»: этот статус полезен только тогда, когда означает, что файл действительно принят в коллекцию.
Практический сценарий: очистка библиотеки от похожих версий
Начинать очистку лучше с наиболее надёжных кандидатов. Сначала подготовьте duplicates search с distance 0 и отдельно обработайте pixel duplicates. Это даст пары, где различия минимальны и решение легче проверить. Настройте metadata merge так, чтобы полезные теги, рейтинги и URL переходили на сохраняемую версию.
После нескольких сотен ручных решений станет понятно, какие закономерности характерны именно для вашей библиотеки. Возможно, часто встречаются JPEG и PNG с одинаковыми пикселями, повторно сохранённые JPEG или превью меньшего разрешения. Только теперь имеет смысл создавать semi-automatic auto-resolution rule на узкий, очевидный случай.
Запустите preview и вручную просмотрите pending actions. Если хотя бы часть пар требует субъективного выбора, правило слишком широкое для автоматического удаления. Уточните filetype, размер, разрешение или metadata flags. Fully automatic оправдан, когда критерий настолько узкий, что проверка десятков или сотен пар не обнаруживает исключений.
Для визуально похожих изображений с watermark, кропом, цветокоррекцией или изменённым текстом лучше сохранять человеческое решение. Часть таких пар следует оставить как alternates. Цель duplicate system — структурировать отношения и убрать действительно лишние копии, а не любой ценой свести библиотеку к одному файлу на сюжет.
Практический сценарий: обмен коллекцией с внешними инструментами
Когда обработка выполняется в другом приложении, используйте экспорт как границу. Выберите нужную выборку в Hydrus, откройте share -> export -> files, задайте стабильный filename pattern и, если внешняя система понимает метаданные, добавьте sidecar. В отдельном тестовом каталоге проверьте, что имена уникальны, namespace выгружаются корректно и JSON/TXT читается целевым инструментом.
После внешнего редактирования не заменяйте файл внутри client_files. Импортируйте полученный результат как новый объект. Если это новая визуальная версия того же содержания, найдите пару через duplicates system и назначьте appropriate relationship. Так сохраняются исходник, история тегов и возможность вернуться к более ранней версии.
Для скриптов, которые должны передавать в Hydrus URL или добавлять теги, Client API обычно лучше обмена через временные папки. Создайте отдельный API key с минимальными правами и оставьте доступ локальным. Скрипт может сначала проверить, доступен ли клиент, затем отправить объект и получить результат операции. Ошибку API следует логировать, а не считать молчаливым успехом.
Практический сценарий: отдельные уровни доверия к тегам
Веб-источники отличаются качеством разметки. Если автоматически смешивать их теги с вручную выверенными, со временем становится трудно понять происхождение каждого термина. Hydrus решает эту проблему несколькими tag services. Оставьте my tags для ручной классификации, downloader tags для обычного импорта сайтов и создайте ещё один локальный сервис для источника, которому доверяете только частично.
В Tag Import Options проблемного URL Class направьте теги в этот отдельный сервис. Затем whitelist оставьте только для пространств, которые действительно полезны: например, creator:, series: и character:. Ненадёжные неименованные теги не попадут в основную систему, но исходные данные при необходимости можно сохранить отдельно.
Если позже качество источника изменится, достаточно поменять правило будущих импортов. Для уже загруженных файлов можно выполнить metadata refetch с новой конфигурацией, но такую операцию следует запускать целенаправленно: повторное получение страниц расходует сеть и время. Сначала проверьте десяток URL.
Безопасность, приватность и сетевые функции
Локальный клиент не требует центрального аккаунта для работы с личной коллекцией. Сетевые возможности включаются отдельными действиями: пользователь добавляет downloader, repository, Client API или подключается к серверу. Это позволяет держать приватную медиатеку без публикации тегов и файлов.
Однако «локальный по умолчанию» не отменяет рисков пользовательской конфигурации. API, открытый на внешний интерфейс, импортированные cookies, логин-скрипты и сторонние downloader-объекты увеличивают поверхность взаимодействия. Не выдавайте API-инструменту больше прав, чем ему требуется, не используйте важные аккаунты в старой login-системе и не публикуйте файлы конфигурации, содержащие сессионные данные.
Отдельный Hydrus Server предназначен для обмена файлами или тегами между пользователями и не нужен для обычной базы на одном компьютере. Если задача — просто открыть свою коллекцию с соседнего ноутбука, не следует автоматически выставлять Client API в интернет. Надёжнее сначала определить модель доступа: локальная сеть, VPN, удалённый рабочий стол или специально настроенный сервер с понятной аутентификацией.
Публичный tag repository передаёт общие теги и отношения, поэтому добавление или петиция на удалённом сервисе — не то же самое, что локальное редактирование. Субъективные группы, приватные пометки и рабочие статусы храните в локальном service. Так случайная синхронизация не превращает личную таксономию в предложение сообществу.
Горячие клавиши, которые ускоряют повседневную работу
| Действие | Клавиша или путь | Когда полезно |
|---|---|---|
| Создать страницу | F9 |
Новый поиск или специальная рабочая страница |
| Управлять тегами | F3 |
Массовое назначение и снятие тегов |
| Управлять рейтингами | F4 |
Оценка выбранных файлов |
| Архивировать | F7 |
Перевести обработанный файл из inbox |
| Вернуть в inbox | Shift+F7 |
Отменить архивирование |
| Archive/delete filter | F12 |
Последовательная обработка партии |
| Удалить | Delete |
Отправить выбранный объект в trash |
| Новый file search | Ctrl+T и выбор страницы |
Быстрый переход к новому запросу |
| Масштаб media viewer | Ctrl + колесо |
Сравнение деталей изображения |
| Следующий/предыдущий файл | колесо, Page Up/Page Down | Просмотр текущей выборки |
Hydrus позволяет переназначать многие shortcut actions, поэтому таблица отражает стандартные/документированные действия, а не непреложную раскладку любой пользовательской установки. Если сочетание ведёт себя иначе, проверьте активный shortcut set и контекст окна перед тем, как считать функцию отсутствующей.
Что не стоит пытаться делать в Hydrus
Hydrus не является полноценным растровым редактором. Он не заменяет инструменты экспозиции, локальной ретуши, клонирования, удаления объектов, слоёв и цветокоррекции. Можно открыть файл во внешней программе и вернуть результат, но сама сильная сторона Hydrus — хранение, классификация, поиск, загрузка и отношения между файлами.
Программа также не является прозрачным индексом существующего дерева папок. Если требуется, чтобы Lightroom-подобный каталог видел оригиналы на месте и любые изменения внешней программы сразу отражались на тех же файлах, внутреннее копирующее хранилище Hydrus может противоречить этому процессу.
Не стоит использовать огромную страницу system:everything как постоянный «домашний экран» на базе из сотен тысяч объектов. Поиск и лимиты существуют именно для того, чтобы показывать рабочий срез. Большая база сама по себе допустима; огромный активный GUI-набор — отдельная нагрузка.
Наконец, не надо строить сложнейшую таксономию заранее. Siblings, parents, несколько tag services и custom import options дают много свободы, но каждая абстракция требует сопровождения. Добавляйте её после того, как возник повторяющийся реальный запрос: исправлять одинаковые варианты имени, группировать серию, фильтровать конкретный источник или разделять доверие к тегам.
Сравнение с аналогами
Hydrus Network удобнее сравнивать не по количеству кнопок, а по модели работы. Он совмещает собственное хранилище, теговую БД, веб-загрузчики, подписки и развитую систему отношений между похожими файлами. ФотоМАСТЕР, digiKam и TagStudio пересекаются с ним лишь частично, поэтому выбор зависит от того, что именно является центром процесса: редактирование изображения, фотографический каталог, тегирование существующих файлов или автономная «booru-подобная» медиатека.
Hydrus Network и ФотоМАСТЕР
ФотоМАСТЕР — прежде всего фоторедактор. Он предлагает коррекцию изображения, ретушь портретов, удаление объектов и замену фона, а также набор фильтров и эффектов. Экспорт ориентирован на получение готового изображения в распространённых форматах. Эти задачи Hydrus не выполняет: его media viewer показывает материал, но не превращается в ретуширующий редактор.
Hydrus, в свою очередь, решает то, для чего ФотоМАСТЕР не предназначен: ведёт большие теговые коллекции, связывает теги с хэшами, собирает файлы загрузчиками и подписками, хранит URL источников и помогает разбирать дубликаты. Практичный совместный процесс выглядит так: Hydrus находит и организует исходники, нужный файл экспортируется в ФотоМАСТЕР для коррекции, а отредактированный результат возвращается в Hydrus как отдельная версия.
Если задача пользователя — поправить свет, кожу, фон или удалить объект на нескольких фотографиях, сложная база Hydrus будет лишней. Если проблема звучит как «у меня сто тысяч картинок и я не могу найти нужную, одни и те же работы приходят с разных сайтов, а новые публикации надо автоматически отслеживать», фоторедактор не заменяет каталогизатор.
Hydrus Network и digiKam
digiKam ближе к классическому DAM для фотографий. Он работает с альбомами и тегами, читает и редактирует фото-метаданные EXIF/IPTC/XMP, поддерживает поиск, карты/геоданные, распознавание лиц, похожие изображения, RAW-процесс и встроенное редактирование. Для фотографа, который хранит снимки в осмысленной файловой структуре и хочет каталог вместе с фотоспецифическими инструментами, это сильная альтернатива.
Hydrus делает акцент иначе. Импортированная копия попадает во внутреннее хранилище; теги и URL сайтов являются первоклассной частью базы; downloader-объекты, watcher и subscriptions встроены в рабочую модель. Его duplicate system различает potential duplicates, duplicates и alternates и умеет переносить метаданные при решении пары. Для интернет-медиатеки эти механизмы часто важнее RAW и EXIF.
Выбор между ними определяется происхождением коллекции. Камерный архив с датами съёмки, географией, лицами и RAW логичнее обслуживать в фотокаталогизаторе. Смешанная коллекция иллюстраций, анимаций, видео и материалов с booru-подобных сайтов лучше совпадает с концепцией Hydrus. Оба продукта умеют теги и поиск, но окружающая инфраструктура у них различна.
Hydrus Network и TagStudio
TagStudio тоже строит организацию вокруг тегов и пользовательских полей, но сохраняет более прямую связь с обычной файловой системой. Библиотека сканирует выбранную директорию, а записи соответствуют файлам, остающимся на своих местах. Поддерживаются теги с алиасами и отношениями, собственные текстовые/датовые поля и логический поиск с AND/OR/NOT.
Для пользователя, который хочет добавить теговый слой поверх существующих папок и не копировать медиатеку во внутреннее хранилище, такой подход проще. Hydrus требует принять свою модель импорта, зато получает более жёсткую идентификацию по хэшу, историю URL, downloader ecosystem, subscriptions, inbox/archive и отдельный конвейер похожих файлов.
Есть и эксплуатационная разница. В TagStudio перемещение или переименование внешних файлов напрямую связано с необходимостью поддерживать соответствие библиотеки путям. Hydrus после импорта больше не зависит от исходного расположения, потому что работает со своей копией. Это достоинство для автономного архива и ограничение для совместной работы нескольких приложений над одной папкой.
Сводное сравнение по задачам
| Задача | Hydrus Network | ФотоМАСТЕР | digiKam | TagStudio |
|---|---|---|---|---|
| Теговая каталогизация | Основная модель, несколько tag services | Не основная задача | Теги и альбомы | Основная модель |
| Редактирование пикселей | Через внешнюю программу | Сильная сторона | Есть встроенный редактор | Не основная задача |
| Работа с исходными папками на месте | Нет, импортирует во внутреннее хранилище | Открывает отдельные изображения | Каталогизирует файловую библиотеку | Сканирует выбранную библиотеку |
| Веб-загрузчики и подписки | Галереи, watcher, subscriptions | Нет такой модели | Есть сетевой экспорт/интеграции, но не hydrus-подобные загрузчики | Не центральная функция |
| Поиск похожих файлов | pHash, duplicate relationships, фильтр | Не каталогизационная функция | Поиск сходства и дубликатов | Не главный сценарий |
| Фото-метаданные и RAW | Хранит/учитывает часть свойств, не RAW-редактор | Редактирование фото | Сильная фотоспецифическая часть | Универсальные поля/теги |
Таким образом, Hydrus не является «лучшей версией» любого из этих продуктов. Он занимает конкретную нишу: большая личная медиатека, где важны теги, происхождение из интернета, автоматическое получение новых материалов и контроль похожих версий. При другой центральной задаче сравниваемый продукт может лучше соответствовать процессу без необходимости воспроизводить функции Hydrus.
Ограничения, которые нужно принять до миграции
Первое ограничение — копирующее внутреннее хранилище. Это делает базу независимой от исходных папок и позволяет уверенно работать по хэшам, но требует дополнительного места и меняет привычный файловый процесс. Если пользователь принципиально хочет, чтобы «оригинал лежит там, где я его положил, и все программы редактируют именно его», Hydrus придётся ставить рядом с этой схемой, а не вместо неё.
Второе — высокий порог настройки продвинутых возможностей. Простые теги и импорт осваиваются быстро, но URL Classes, парсеры, import option stacks, tag repositories, siblings/parents, Client API и auto-resolution имеют собственную терминологию. Их не нужно изучать одновременно. Тем не менее пользователь, который хочет раскрыть сетевую автоматизацию, неизбежно столкнётся с техническими настройками.
Третье — отсутствие полноценного редактора изображения. Сортировка, просмотр и сравнение не заменяют ретушь, RAW-проявку и работу со слоями. Для таких задач Hydrus должен сотрудничать с внешним редактором через экспорт и повторный импорт.
Четвёртое — загрузчики зависят от сайтов. Изменение HTML/API может временно сломать конкретный источник, а некоторые современные авторизации плохо подходят старой login-системе. Hydrus даёт инструменты обновления конфигураций и cookies, но не может гарантировать вечную совместимость с чужим сайтом.
Пятое — мощные операции требуют осторожности на больших объёмах. Массовые parent relationships, repository sync, duplicate discovery и автоматические правила способны загрузить CPU/диск или изменить тысячи связей. Резервная копия и тест на малой выборке здесь являются частью нормального процесса, а не факультативной перестраховкой.
Настройка, которую имеет смысл сделать в первый день
Не нужно сразу перестраивать весь интерфейс. Достаточно создать рабочую основу, которая предотвращает самые дорогие ошибки. Сначала выберите место базы на локальном диске и настройте резервное копирование. Затем импортируйте тестовую папку без удаления оригиналов и убедитесь, что понимаете разницу между inbox, archive и trash.
После этого определите два-три namespace, которыми действительно будете пользоваться. Для большинства коллекций полезны автор/создатель, серия или проект и служебный workflow/source. Освойте F3, favourite search и system:limit. Уже этого достаточно, чтобы Hydrus приносил пользу как теговая база.
Сетевые функции добавляйте по одной. Импортируйте один downloader, проверьте маленькую Gallery-задачу, изучите, куда попадают теги, и только потом создайте subscription. Не подключайте PTR, API и автоматическое удаление дубликатов в один вечер: если результат окажется неожиданным, будет сложно понять, какая система его породила.
Когда коллекция стабильно импортируется и ищется, настройте export pattern и sidecar для аварийного вывода данных. Это полезно даже если миграция не планируется: вы заранее знаете, как получить из базы обычные файлы с понятными именами и сопутствующими тегами.
Кому Hydrus Network подходит лучше всего
Программа особенно уместна для пользователя, у которого медиатека выросла из интернет-источников и перестала помещаться в одно логичное дерево папок. Здесь важны не даты фотосессий, а авторы, серии, персонажи, варианты одного изображения, URL происхождения и регулярные новые публикации. Теговая модель, subscriptions и duplicate relationships работают на одну и ту же задачу.
Hydrus также подходит тем, кто готов считать базу отдельной системой хранения, а не украшением поверх каталогов. Взамен пользователь получает устойчивую идентификацию по хэшам и возможность полностью изменить видимую классификацию, не перемещая сами файлы между папками.
Если же библиотека небольшая, поиск по папкам уже решает все задачи, а основная работа — редактировать отдельные фотографии, затраты на освоение Hydrus неоправданны. То же относится к процессу, где несколько приложений обязаны работать с одним набором оригиналов на месте. В таких случаях проще использовать фоторедактор, DAM или теггер, который индексирует существующую файловую структуру.
Итоговый рабочий подход
Hydrus Network лучше всего раскрывается не как «папка с картинками», а как база, в которой файл является устойчивым объектом с хэшем, тегами, URL, рейтингами и отношениями. Импорт создаёт контролируемую копию, inbox отделяет новые поступления от принятых, predicates формируют рабочие выборки, а Gallery/Subscriptions автоматизируют пополнение.
Надёжный процесс строится постепенно: маленький тестовый импорт, простая схема тегов, ограниченные поисковые страницы, резервная копия, затем один проверенный downloader и только после этого более сложные правила. Duplicates filter и auto-resolution следует подключать после накопления реального опыта на собственной коллекции, потому что решение о «лучшей» версии зависит от содержимого и метаданных, а не только от размера файла.
При таком использовании сильные стороны Hydrus складываются в единый конвейер: материалы приходят из диска или сети, получают разметку, попадают в inbox, находятся по комбинированным условиям, сравниваются с похожими версиями и при необходимости экспортируются вместе с метаданными. Главная цена этой целостности — необходимость принять внутреннее хранилище и освоить терминологию программы. Если эти условия совпадают с задачей большой личной медиатеки, Hydrus способен заменить множество ручных операций устойчивыми повторяемыми сценариями.